Crawling dan Indexing Google: Pengertian, Perbedaan, dan Cara Kerjanya
Sebelum sebuah halaman berpeluang muncul di hasil pencarian, mesin pencari perlu menemukan URL, mengaksesnya, memproses isinya, lalu menentukan apakah halaman tersebut akan disimpan dalam indeks. Memahami tahap ini membantu diagnosis SEO menjadi lebih tepat.
Crawling adalah proses ketika crawler mesin pencari menemukan dan mengambil halaman atau resource dari website. Indexing adalah tahap ketika mesin pencari memproses, memahami, dan mempertimbangkan halaman tersebut untuk disimpan dalam indeks. URL yang berhasil di-crawl belum tentu diindeks, dan URL yang belum ditemukan atau tidak dapat diakses dengan baik akan lebih sulit masuk ke tahap berikutnya.
Apa Itu Crawling dan Indexing?
Crawling dan indexing adalah dua proses berbeda yang saling berhubungan dalam cara mesin pencari memahami web. Sebelum membahas ranking, keyword, atau backlink, sebuah URL perlu lebih dahulu dapat ditemukan dan diproses. Karena itu keduanya merupakan bagian penting dari Technical SEO.
Crawling terjadi ketika crawler mengunjungi URL dan mengambil informasi yang tersedia. URL baru dapat ditemukan melalui link dari halaman lain, sitemap, atau sumber discovery lainnya. Setelah konten diperoleh, mesin pencari dapat memproses HTML, resource, dan sinyal lain yang berkaitan dengan halaman tersebut.
Indexing adalah proses lanjutan ketika mesin pencari menganalisis halaman, memahami isi serta sinyalnya, memilih versi representatif bila terdapat duplikasi, dan menentukan apakah halaman layak disimpan dalam indeks. Masuk indeks tidak berarti otomatis memperoleh ranking tinggi; indexing hanya membuat halaman tersedia untuk dipertimbangkan dalam hasil pencarian yang relevan.
Apa Perbedaan Crawling dan Indexing?
Perbedaan paling sederhana terletak pada fungsinya. Crawling berkaitan dengan penemuan dan pengambilan, sedangkan indexing berkaitan dengan pemrosesan dan penyimpanan. Sebuah halaman dapat berhasil di-crawl tetapi tidak diindeks karena canonical, instruksi noindex, duplikasi, kualitas atau kegunaan halaman, maupun keputusan sistem mesin pencari.
noindex, URL tersebut tidak seharusnya dimasukkan ke indeks. Jadi “bisa di-crawl” dan “bisa diindeks” bukan kondisi yang sama.Bagaimana Proses dari URL Ditemukan hingga Masuk Indeks?
Secara konseptual, perjalanan halaman dapat dibaca sebagai beberapa tahap. Urutan ini berguna ketika mendiagnosis masalah karena kegagalan pada satu tahap dapat memengaruhi tahap berikutnya.
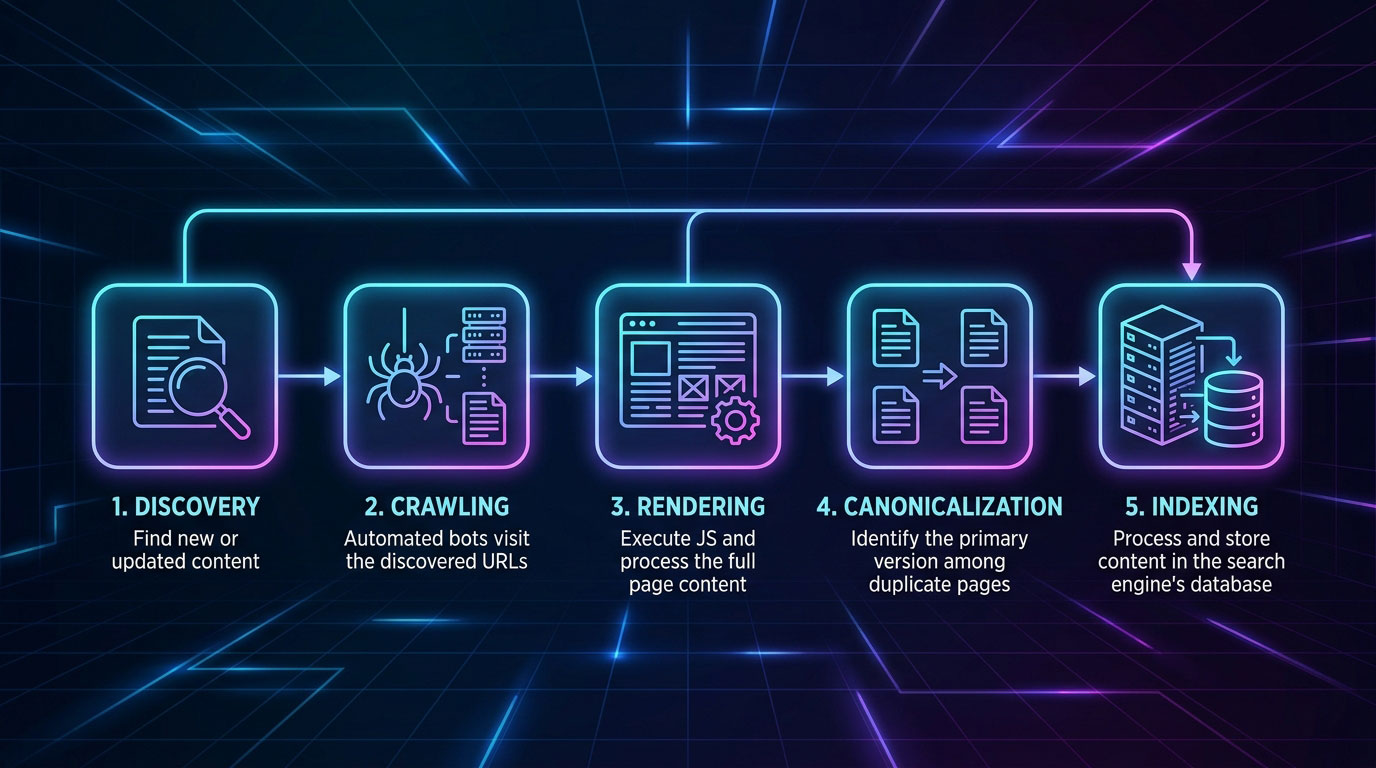
Alur tersebut bukan tombol yang dapat dipaksa satu per satu. Sitemap dan request indexing dapat membantu discovery atau meminta pemeriksaan ulang, tetapi keduanya bukan jaminan sebuah URL akan disimpan dalam indeks atau memperoleh posisi tertentu.
Periksa Technical SEO, Indexability, On-Page, Internal Link, Backlink, dan Performance sebelum menentukan tindakan optimasi.
Apa Itu Crawlability?
Crawlability menggambarkan seberapa mudah crawler dapat menemukan dan mengakses halaman yang memang ingin Anda buka untuk mesin pencari. Website dengan navigasi yang jelas dan internal link HTML yang dapat diikuti biasanya memberi jalur discovery yang lebih baik dibanding halaman yang hanya diketahui melalui form, pencarian internal, atau interaksi yang rumit.
Robots.txt juga memengaruhi akses crawling. Aturan yang terlalu luas dapat mencegah crawler mengakses direktori atau resource tertentu. Sebaliknya, membiarkan semua URL terbuka tanpa kontrol juga bukan selalu solusi, terutama pada situs besar yang menghasilkan banyak filter, parameter, kalender, atau URL duplikat.
Internal link membantu discovery URL
Internal link bukan hanya alat distribusi konteks dan otoritas ant halaman. Link juga menyediakan jalur bagi crawler untuk menemukan halaman baru. Halaman penting yang tidak memiliki link masuk internal dapat menjadi orphan page dan lebih sulit ditemukan melalui struktur website normal.
Sitemap XML membantu, tetapi bukan pengganti struktur website
Sitemap XML dapat memberi daftar URL yang ingin Anda informasikan kepada mesin pencari. Namun sitemap sebaiknya berisi URL canonical, aktif, dan memang ditujukan untuk indeks. Memasukkan URL ke sitemap tidak memperbaiki halaman yang diblokir, noindex, error, atau memiliki sinyal canonical yang bertentangan.
Apa Itu Indexability?
Indexability berkaitan dengan apakah sebuah halaman secara teknis tersedia untuk dipertimbangkan masuk indeks. Pemeriksaannya mencakup status HTTP, meta robots atau X-Robots-Tag, canonical, akses terhadap konten utama, serta konflik sinyal yang mungkin membuat mesin pencari memilih URL lain.
Halaman yang mengembalikan 200 dan tidak memiliki noindex pun belum otomatis dijamin terindeks. Mesin pencari tetap melakukan evaluasi terhadap halaman dan keseluruhan situs. Karena itu diagnosis indexing tidak boleh berhenti pada satu tag HTML saja.
Canonical bukan perintah indexing
Canonical membantu menunjukkan versi representatif di antara URL yang sama atau sangat mirip. Jika beberapa URL menampilkan konten serupa, mesin pencari dapat mengelompokkan sinyal dan memilih canonical. Konsistensi antara canonical, internal link, sitemap, redirect, dan URL yang benar-benar ingin dipakai sangat penting agar sinyal tidak saling bertentangan.
Mengapa Google Tidak Crawl atau Tidak Mengindeks Halaman?
Penyebabnya perlu dipisahkan berdasarkan tahap. Bila URL belum ditemukan, fokus pertama adalah discovery. Bila URL ditemukan tetapi tidak dapat diakses, periksa crawling dan respons server. Bila URL dapat diakses tetapi tidak masuk indeks, pemeriksaannya bergeser ke indexability, canonical, duplikasi, kualitas halaman, dan sinyal situs.
1. URL sulit ditemukan
Halaman baru tanpa internal link, tidak masuk struktur kategori, dan tidak tercantum pada sitemap dapat memiliki jalur discovery yang lemah. Hubungkan halaman dari bagian website yang relevan dan pastikan tidak menjadi halaman yatim.
2. Robots.txt menghambat crawling
Periksa apakah aturan robots.txt memblokir path yang sebenarnya perlu diakses. Jangan menggunakan robots.txt sebagai pengganti noindex karena crawler yang dilarang mengakses halaman mungkin tidak dapat membaca instruksi yang ada di dalam HTML halaman tersebut.
3. Respons server atau redirect bermasalah
Error 5xx, timeout, redirect loop, atau rantai redirect yang tidak perlu dapat menyulitkan akses. Pastikan URL penting memberikan respons yang konsisten dan internal link menuju URL final.
4. Terdapat instruksi noindex
Meta robots atau X-Robots-Tag dapat secara sengaja meminta agar halaman tidak diindeks. Ini berguna untuk halaman tertentu, tetapi menjadi masalah ketika tertinggal setelah staging, migrasi, atau perubahan template.
5. Canonical menunjuk ke URL lain
Bila halaman menunjuk canonical ke URL berbeda, itu merupakan sinyal bahwa versi lain adalah representatif. Audit canonical terutama setelah redesign, migrasi HTTPS, perubahan www/non-www, atau restrukturisasi URL.
6. Konten sangat mirip atau memiliki nilai yang terbatas
Banyak URL dengan isi hampir sama—misalnya hasil filter, tag tipis, halaman parameter, atau variasi otomatis—dapat menciptakan duplikasi dan memperbesar ruang URL yang perlu diproses. Konsolidasikan halaman bila beberapa URL sebenarnya melayani kebutuhan yang sama.
7. Konten penting bergantung pada rendering yang bermasalah
JavaScript bukan otomatis buruk untuk SEO. Masalah muncul bila konten utama atau link hanya tersedia setelah interaksi tertentu, resource gagal dimuat, atau hasil render berbeda dari yang diharapkan. Pada aplikasi modern, periksa HTML dan hasil render halaman penting.
Cara Membantu Google Menemukan dan Memproses Halaman Penting
Mulailah dengan struktur yang sederhana dan konsisten. Pastikan halaman penting memiliki link dari halaman lain yang relevan, menggunakan URL final, mengembalikan respons yang benar, tidak diblokir secara tidak sengaja, dan memberikan sinyal canonical yang sesuai.
Sitemap XML sebaiknya diperbarui ketika URL penting berubah. Hindari memasukkan URL redirect, error, noindex, atau duplikat yang bukan canonical. Setelah menerbitkan halaman baru, link-kan dari halaman hub atau artikel terkait agar discovery tidak bergantung hanya pada sitemap.
Untuk URL tertentu yang ingin diperiksa, gunakan URL Inspection di Google Search Console. Tool tersebut membantu melihat status yang diketahui Google dan dapat digunakan untuk meminta indexing ketika memang diperlukan. Panduan langkah demi langkahnya sudah dibahas terpisah pada artikel cara cek apakah website sudah terindex Google.
Cara Mendiagnosis Masalah Crawling dan Indexing Secara Sistematis
Diagnosis yang baik dimulai dari pertanyaan sederhana: apakah URL diketahui, apakah bisa diakses, apakah boleh diindeks, dan apakah sinyal URL konsisten? Jangan langsung mengubah konten atau membangun backlink sebelum mengetahui tahap mana yang bermasalah.
Pendekatan ini juga membuat proses cek SEO website lebih efisien. Temuan dapat dikelompokkan berdasarkan akar masalah, bukan berdasarkan banyaknya warning yang muncul dari sebuah tool.
Apakah Crawl Budget Perlu Dikhawatirkan?
Untuk banyak website kecil dan menengah, prioritas biasanya bukan mengejar “crawl budget” sebagai angka, melainkan memastikan struktur situs tidak menghasilkan ruang URL yang tidak terkendali. Masalah seperti parameter tak terbatas, kalender, faceted navigation, duplicate URL, redirect chain, dan server yang tidak stabil lebih konkret untuk diperiksa.
Pada website yang sangat besar atau sering berubah, efisiensi crawling menjadi lebih penting. Namun prinsipnya tetap sama: sediakan jalur yang jelas menuju URL penting, kurangi URL yang tidak bernilai, jaga server responsif, dan berikan sinyal teknis yang konsisten.
Apakah Request Indexing Bisa Mempercepat Semuanya?
Request indexing berguna untuk meminta Google memeriksa sebuah URL, terutama setelah publikasi atau perubahan penting. Namun fitur tersebut bukan pengganti struktur internal link, sitemap, kualitas halaman, atau konfigurasi teknis yang benar. Mengirim permintaan berulang tidak menyelesaikan canonical yang salah, noindex, server error, maupun halaman yang tidak memberikan alasan kuat untuk berdiri sendiri.
Gunakan request indexing setelah memastikan fondasi URL sudah benar. Bila banyak halaman memiliki masalah yang sama, perbaiki akar masalah pada template, routing, CMS, atau arsitektur situs daripada menangani setiap URL secara manual.
FAQ Crawling dan Indexing
Apakah halaman yang sudah di-crawl pasti terindex?
Tidak. Crawling berarti crawler telah mengakses halaman, sedangkan indexing merupakan keputusan lanjutan setelah halaman diproses dan dievaluasi.
Apakah sitemap XML menjamin indexing?
Tidak. Sitemap membantu mesin pencari menemukan URL dan memahami daftar halaman yang Anda anggap penting, tetapi bukan jaminan URL akan masuk indeks.
Apakah robots.txt bisa digunakan untuk noindex?
Robots.txt terutama mengatur crawling. Untuk mengendalikan indexing halaman yang dapat diakses, instruksi robots seperti noindex memiliki fungsi berbeda. Konfigurasinya perlu direncanakan agar crawler dapat membaca sinyal yang diperlukan.
Mengapa halaman baru belum muncul di Google?
Halaman baru mungkin belum ditemukan atau belum diproses, tetapi penyebab lain juga mungkin terjadi. Periksa internal link, sitemap, status HTTP, robots, canonical, noindex, serta status URL di Search Console sebelum mengambil kesimpulan.
Apakah halaman terindex berarti SEO-nya sudah bagus?
Tidak. Indexing hanya salah satu prasyarat. Relevansi terhadap search intent, kualitas informasi, struktur halaman, internal link, pengalaman pengguna, dan sinyal lain tetap memengaruhi performa organik.
Crawling dan Indexing Adalah Tahap Diagnosis, Bukan Target Akhir
Tujuan SEO bukan sekadar membuat sebanyak mungkin URL di-crawl atau masuk indeks. Yang lebih penting adalah memastikan halaman yang benar dapat ditemukan, diproses, dan dipahami, sementara URL yang tidak perlu tidak menciptakan kebisingan teknis.
Dengan memisahkan masalah discovery, crawling, rendering, canonicalization, dan indexing, keputusan perbaikan menjadi lebih terarah. Setelah fondasi ini sehat, evaluasi relevansi konten, internal linking, performa, dan sinyal off-page dapat dilakukan dengan konteks yang lebih jelas.
Mulai dari kondisi website yang sebenarnya.
Masukkan URL website untuk menyiapkan pemeriksaan area SEO sebelum menentukan prioritas optimasi berikutnya.
Cek SEO Website →