Robots.txt: Fungsi, Cara Membuat, dan Kesalahan yang Bisa Menghambat SEO
Robots.txt membantu mengatur bagian website yang boleh atau tidak boleh dirayapi crawler. File ini terlihat sederhana, tetapi satu aturan yang terlalu luas dapat menutup akses ke halaman atau resource penting.
Robots.txt adalah file teks pada root website yang memberi aturan crawling kepada crawler. Untuk Google, aturan utamanya meliputi User-agent, Disallow, Allow, dan Sitemap. Robots.txt mengendalikan crawling, bukan alat yang tepat untuk memastikan sebuah URL tidak masuk indeks.
Apa Itu Robots.txt?
Robots.txt adalah file teks yang digunakan website untuk menyampaikan aturan akses crawling kepada robot otomatis. Sebelum crawler Google meng-crawl sebuah situs, crawler dapat mengambil dan membaca robots.txt untuk mengetahui path mana yang diizinkan atau dibatasi. Karena berada di lapisan awal proses crawling, kesalahan konfigurasi dapat berdampak luas pada discovery dan pemrosesan halaman.
Robots.txt merupakan bagian dari Technical SEO. Ia tidak menentukan kualitas artikel, keyword, atau backlink. Perannya lebih spesifik: membantu mengontrol akses crawler terhadap bagian tertentu dari struktur URL website.
Apa Fungsi Robots.txt untuk SEO?
Fungsi utama robots.txt adalah mengatur crawl access. Pada situs sederhana, file ini mungkin hanya mengizinkan crawler mengakses seluruh website sekaligus memberi tahu lokasi sitemap. Pada situs yang lebih kompleks, robots.txt dapat dipakai untuk membatasi area tertentu yang tidak perlu dirayapi, selama dampaknya sudah dipahami.
Contohnya adalah area administratif, pola URL tertentu, atau ruang URL yang memang tidak perlu diakses crawler. Namun memblokir URL hanya karena Anda tidak ingin URL tersebut muncul di Google adalah pendekatan yang berbeda. Crawling dan indexing harus dipisahkan, sebagaimana dijelaskan pada panduan crawling dan indexing Google.
Disallow membatasi crawling. URL yang diblokir masih dapat diketahui Google dari link atau sumber lain, sehingga pengendalian indexing membutuhkan strategi yang tepat.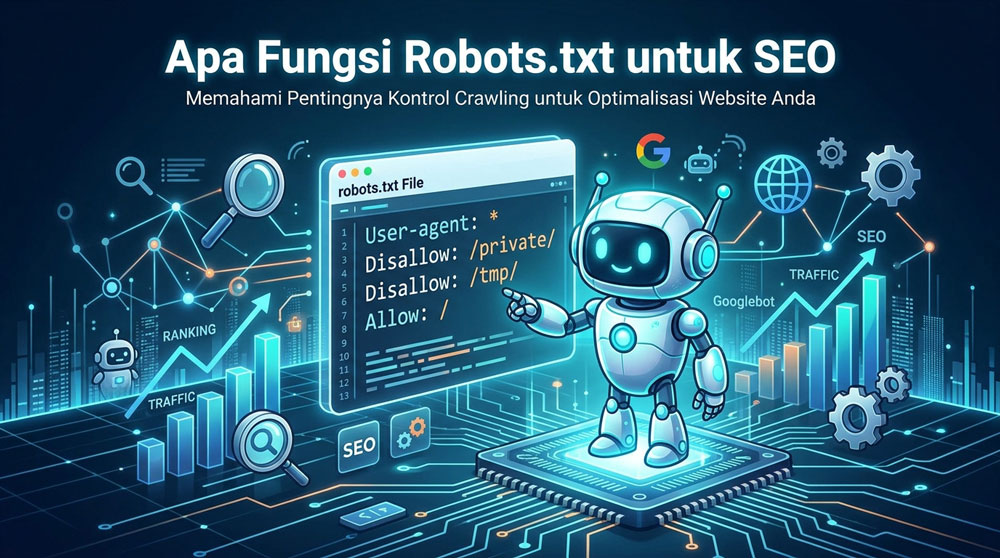
Di Mana Robots.txt Harus Diletakkan?
Robots.txt harus tersedia di direktori paling atas dari host yang ingin diatur, misalnya https://example.com/robots.txt. Aturan berlaku pada kombinasi host, protokol, dan port tempat file tersebut berada. Karena itu robots.txt pada satu subdomain tidak otomatis mengatur subdomain lain.
File dan path juga perlu diperlakukan dengan presisi. Kesalahan kecil pada lokasi, host, atau pola path dapat membuat aturan tidak bekerja seperti yang diasumsikan. Saat audit, jangan hanya melihat isi file; pastikan URL robots.txt benar-benar dapat diakses dan respons servernya sesuai.
Memahami Syntax Robots.txt
Untuk penggunaan Google Search, empat elemen yang paling penting dipahami adalah User-agent, Disallow, Allow, dan Sitemap. Masing-masing mempunyai fungsi berbeda.
1. User-agent
User-agent menentukan crawler yang menjadi sasaran sebuah kelompok aturan. Tanda bintang (*) lazim digunakan untuk aturan yang berlaku bagi semua crawler yang mengikuti protokol tersebut.
2. Disallow
Disallow menentukan path yang tidak boleh di-crawl oleh user-agent pada kelompok tersebut. Karena satu karakter dapat mengubah cakupan aturan, konfigurasi sebaiknya diuji sebelum diterapkan ke website produksi.
3. Allow
Allow dapat memberi izin pada path tertentu ketika bagian yang lebih luas dibatasi. Ini berguna ketika struktur direktori memiliki pengecualian yang memang harus tetap dapat diakses crawler.
4. Sitemap
Baris Sitemap dapat menunjukkan URL lengkap sitemap XML. Sitemap membantu discovery URL, tetapi tidak menggantikan internal linking dan tidak menjamin halaman akan diindeks.
Contoh Robots.txt Sederhana
Untuk website yang ingin membuka crawling secara umum dan memberi tahu lokasi sitemap, konfigurasi dapat dibuat sangat sederhana:
User-agent: *
Disallow:

Sitemap: https://example.com/sitemap.xml
Baris Disallow: tanpa path tidak memblokir direktori tertentu. Bila Anda memang ingin membatasi sebuah area, path harus ditulis dengan hati-hati dan sesuai struktur situs.
Contoh membatasi sebuah direktori
User-agent: *
Disallow: /private/

Sitemap: https://example.com/sitemap.xml
Contoh tersebut menyatakan crawler yang mengikuti aturan agar tidak meng-crawl URL pada path /private/. Jangan menyalin pola ini ke website produksi tanpa memastikan bahwa tidak ada halaman atau resource penting di dalam path tersebut.
Robots.txt vs Meta Robots Noindex: Apa Bedanya?
Ini salah satu bagian yang paling sering keliru. Robots.txt mengatur crawling, sedangkan noindex mengatur indexing ketika instruksi tersebut dapat dibaca oleh crawler. Bila sebuah halaman diblokir melalui robots.txt, crawler mungkin tidak dapat mengambil HTML halaman dan karena itu tidak dapat melihat meta robots noindex yang diletakkan di dalamnya.
Artinya, kombinasi “blokir dengan robots.txt + pasang noindex” bukan strategi yang otomatis lebih kuat. Jika tujuan Anda adalah membuat Google membaca instruksi noindex, Google perlu dapat mengakses halaman untuk melihat instruksi tersebut. Untuk URL yang sudah diketahui mesin pencari, diagnosis statusnya dapat dilanjutkan melalui panduan cara cek apakah website sudah terindex Google.
Apakah Robots.txt Bisa Menghemat Crawl Budget?
Pada website sangat besar, pengendalian ruang URL memang dapat membantu crawler tidak menghabiskan akses pada bagian yang benar-benar tidak perlu dirayapi. Namun robots.txt bukan trik untuk “memindahkan” jatah crawling secara otomatis ke halaman lain. Pada banyak website kecil dan menengah, masalah yang lebih penting justru struktur internal link, duplikasi URL, parameter yang tidak terkendali, redirect, error server, dan kualitas arsitektur.
Karena itu jangan membuat aturan kompleks hanya karena terdengar teknis. Semakin rumit robots.txt, semakin besar kebutuhan dokumentasi dan pengujian saat struktur website berubah.
Kesalahan Robots.txt yang Bisa Menghambat SEO
1. Tidak sengaja memblokir seluruh website
Aturan Disallow: / pada kelompok yang berlaku untuk crawler dapat menutup crawling seluruh situs. Kasus seperti ini sering terjadi ketika konfigurasi staging terbawa ke production setelah migrasi atau redesign.
2. Memblokir CSS atau JavaScript penting
Resource yang dibutuhkan untuk merender halaman sebaiknya tidak diblokir tanpa alasan yang jelas. Bila crawler tidak dapat mengakses resource penting, pemrosesan tampilan dan konten halaman dapat menjadi kurang lengkap.
3. Menganggap Disallow sama dengan noindex
Ini kesalahan konsep. URL yang dilarang di-crawl masih dapat diketahui melalui link eksternal atau internal. Bila Google mengetahui URL tetapi tidak dapat meng-crawl kontennya, URL dalam kondisi tertentu masih dapat muncul tanpa snippet yang lengkap.
4. Memblokir path terlalu luas
Aturan untuk sebuah folder dapat ikut mengenai halaman turunan yang sebenarnya penting. Audit pola URL sebelum menambahkan aturan dan cek kembali setelah deployment.
5. Lupa memperbarui robots.txt setelah migrasi
Website staging sering dibatasi dari crawler. Saat situs dipindahkan ke domain produksi, aturan lama harus diperiksa agar tidak ikut memblokir situs baru. Robots.txt layak masuk checklist setiap migrasi.
6. Mengandalkan robots.txt untuk menyelesaikan duplikasi
Duplikasi URL dapat memerlukan canonical, redirect, perubahan internal link, atau perbaikan sistem pembentuk URL. Memblokir crawler tidak otomatis mengonsolidasikan sinyal antar-URL.
7. Menyalin robots.txt website lain
Struktur CMS, plugin, routing, resource, dan kebutuhan crawling setiap website berbeda. File yang aman untuk satu situs belum tentu aman untuk situs lain.
Periksa robots.txt bersama status HTTP, indexability, canonical, sitemap, dan internal link agar diagnosis tidak berhenti pada satu file.
Cara Mengecek Robots.txt Website
Mulailah dengan membuka /robots.txt pada domain yang diperiksa. Baca kelompok user-agent satu per satu dan cocokkan setiap path dengan struktur URL aktual. Cari aturan yang terlalu luas, aturan lama, atau direktori yang sekarang berisi halaman penting.
User-agent yang relevan.Disallow dan Allow, lalu cocokkan dengan URL penting.Sitemap dan pastikan URL sitemap aktif.Robots.txt sebaiknya selalu dibaca bersama sinyal lain. URL tidak terindex belum tentu disebabkan robots.txt; bisa juga karena noindex, canonical, redirect, error, discovery lemah, duplikasi, atau evaluasi sistem terhadap halaman. Pendekatan menyeluruh dibahas pada panduan cek SEO website.
Checklist Sebelum Mengubah Robots.txt
Sebelum deploy, tanyakan tiga hal: URL apa yang ingin dibatasi, crawler mana yang dituju, dan apa dampaknya bila crawler benar-benar tidak dapat mengakses URL tersebut? Bila jawabannya belum jelas, jangan membuat aturan hanya untuk menghilangkan warning tool.
Simpan salinan konfigurasi sebelumnya, uji pada beberapa contoh URL, dan dokumentasikan alasan setiap aturan. Ini sangat membantu ketika website dikelola lebih dari satu orang atau mengalami migrasi beberapa bulan kemudian.
FAQ Robots.txt
Apakah setiap website wajib memiliki robots.txt?
Tidak semua website membutuhkan aturan khusus. Namun robots.txt berguna ketika Anda perlu mengatur crawling atau menyatakan lokasi sitemap. Bila file tidak diperlukan, jangan membuat aturan kompleks tanpa tujuan.
Apakah Disallow membuat halaman hilang dari Google?
Tidak selalu. Disallow membatasi crawling, bukan merupakan mekanisme penghapusan URL dari indeks. URL yang diketahui melalui sumber lain masih dapat dikenali mesin pencari.
Apakah robots.txt bisa berisi sitemap?
Ya. Baris Sitemap: dapat berisi URL lengkap sitemap atau sitemap index dan dapat digunakan bersama aturan crawling. Pelajari pengelolaannya lebih lanjut pada panduan XML sitemap untuk SEO.
Apakah robots.txt peka huruf besar-kecil?
Nama field seperti Disallow tidak bergantung pada kapitalisasi, tetapi nilai path URL perlu diperlakukan sebagai case-sensitive. Karena itu path harus sesuai dengan URL sebenarnya.
Apakah crawl-delay didukung Google?
Google tidak mencantumkan crawl-delay sebagai field robots.txt yang didukung. Jangan mengandalkan directive tersebut untuk mengontrol Googlebot.
Robots.txt Kecil, Dampaknya Bisa Luas
Robots.txt sering hanya berisi beberapa baris, tetapi posisinya di awal proses crawling membuat kesalahannya dapat memengaruhi banyak URL sekaligus. Tujuannya bukan memblokir sebanyak mungkin halaman, melainkan memberi aturan yang sederhana, disengaja, dan sesuai struktur website.
Jika sebuah halaman penting bermasalah, jangan berhenti pada robots.txt. Periksa alur lengkap dari discovery, crawling, respons server, rendering, indexability, canonical hingga internal linking. Dengan begitu, perbaikan dilakukan pada akar masalah dan bukan sekadar menambah directive baru.
Periksa fondasi Technical SEO website.
Mulai dari crawlability dan indexability, lalu tentukan bagian mana yang benar-benar membutuhkan perbaikan.
Cek SEO Website →